ChatGPT non è tutta l’intelligenza artificiale
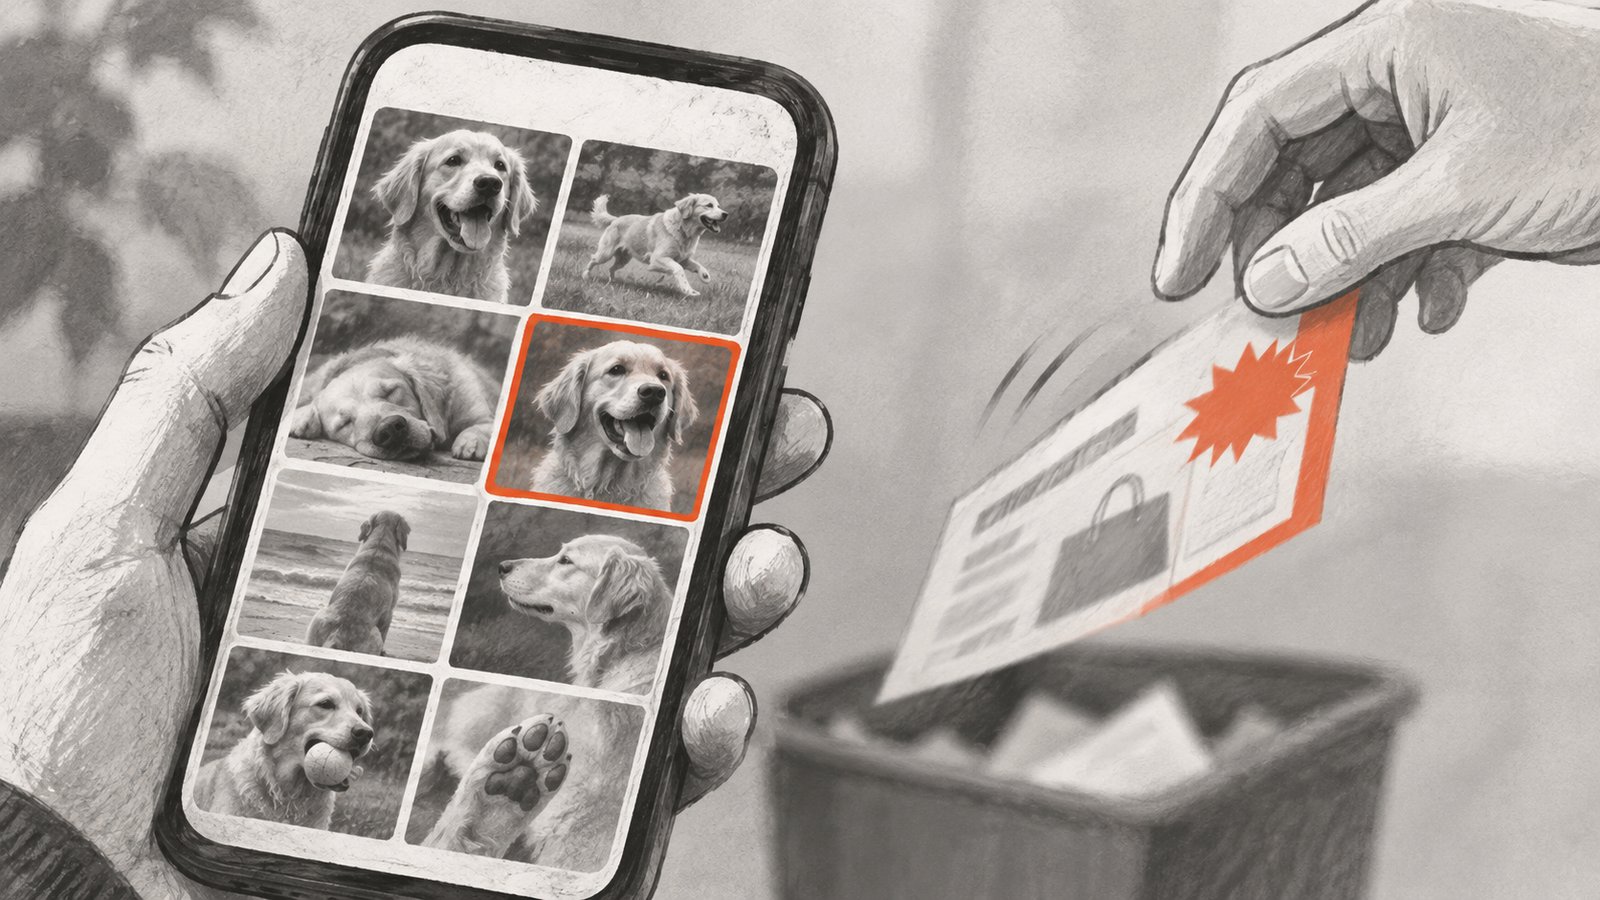
Prendi in mano il telefono. Probabilmente ci sono già almeno tre intelligenze artificiali al lavoro, e non ci hai mai fatto caso. Il filtro che sposta la pubblicità indesiderata nella cartella spam. La galleria che, se scrivi «cane», ti mostra le foto dei cani. La tastiera che ti suggerisce la parola successiva mentre scrivi un messaggio.
Poi apri ChatGPT e pensi: «Adesso sto usando l’intelligenza artificiale». In realtà la usavi già da anni. E quella tastiera, come vedremo, è una lontana parente di ChatGPT.
Questa è la prima puntata di una serie che parte dalla chat che tutti conoscono e arriva agli agenti, ai modelli che girano in casa e agli strumenti che un’azienda può costruirsi. Senza formule: ti spiego cosa serve per capire cosa succede quando premi invio.
Se preferisci guardarla, la puntata è disponibile anche su YouTube: Capire l’AI in 10 minuti: cosa fa davvero ChatGPT.
L’intelligenza artificiale è molto più grande di ChatGPT
Se chiedi in giro che cos’è l’intelligenza artificiale, quasi tutti ti rispondono «ChatGPT». È comprensibile: da quando OpenAI lo ha reso disponibile a tutti, a fine novembre 2022, è diventato il volto pubblico dell’AI. Ma è come dire che l’automobile è una Panda.
L’Unione europea, nel regolamento sull’intelligenza artificiale (l’AI Act), definisce un sistema di IA come «un sistema automatizzato» che, a partire dai dati che riceve, «deduce» come produrre «previsioni, contenuti, raccomandazioni o decisioni». Dentro questa definizione rientrano, per esempio, il filtro antispam che impara dagli esempi e decide che cosa scartare; il navigatore, che prevede il traffico; la piattaforma di streaming, che raccomanda il prossimo film. E rientra anche ChatGPT, che produce contenuti.
Quest’ultima famiglia ha un nome preciso: AI generativa, cioè l’intelligenza artificiale in grado di generare testi, immagini, suoni o video. ChatGPT appartiene a un ramo ancora più stretto: quello dei modelli linguistici.
Che cosa fa davvero un modello linguistico
Torniamo alla tastiera del telefono. Scrivi «Ci vediamo» e lei ti propone «domani». Accetti, e lei propone «alle». Accetti ancora: «otto». Senza aver capito nulla del tuo appuntamento, ha costruito una frase sensata perché ha visto molte frasi simili e sa cosa viene dopo più spesso.
Un LLM, sigla inglese di *large language model* (modello linguistico di grandi dimensioni), fa una cosa secondo la stessa logica di fondo. Riceve un testo e calcola quale pezzo di testo è più probabile che venga dopo. Lo aggiunge, poi ricalcola, e così via, un pezzo alla volta, finché la risposta è completa.
Attenzione al paragone, però: vale per la logica, non per la grandezza. Fra la tastiera e un LLM c’è la differenza che passa fra un monopattino e un aereo. Un LLM tiene conto di ciò che hai scritto prima nella stessa conversazione, anche di pagine intere, fino a un limite misurato in token. Ha studiato una quantità enorme di testo. E in quel calcolo sono finite regole grammaticali, fatti, stili di scrittura, perfino ragionamenti a più passaggi. Per questo le sue risposte sembrano frutto di comprensione. A volte il risultato ci assomiglia davvero; altre volte no, e vedremo perché.
I «pezzi di testo» su cui lavora il modello si chiamano token. Non sempre coincidono con le parole: una parola corta può corrispondere a un solo token, mentre una lunga può richiedere più token. OpenAI, per l’inglese, stima che un token valga in media circa quattro caratteri, cioè tre quarti di parola. In italiano, di solito, ne servono un po’ di più per dire la stessa cosa. E non è un dettaglio da poco: i limiti di lunghezza e i prezzi di questi servizi, quando li paghi a consumo, si calcolano in token.
Parametri: i cursori del mixer
I parametri sono i numeri interni di un modello, fissati durante l’addestramento. Leggerai spesso frasi come «un modello da 8 miliardi di parametri». Che cosa vuol dire?
Immagina un mixer da DJ, ma con miliardi di cursori invece di poche decine. Durante lo studio, ogni cursore viene spostato di pochissimo, milioni di volte, finché il suono che esce, cioè il testo previsto, assomiglia sempre di più a quello giusto. Alla fine i cursori restano fermi in quella posizione. Questa è un’analogia: in concreto, i parametri sono numeri all’interno di una rete di calcolo e sono il risultato dell’addestramento.
Un esempio reale: Qwen3-8B, un modello pubblicato dalla cinese Alibaba e scaricabile liberamente, ha circa 8,2 miliardi di parametri: 8.190.735.360, secondo i dati pubblicati su Hugging Face. Nella versione originale, i file del modello pesano circa 16 GB.
Due avvertenze. Più parametri, di solito, significano più capacità, ma anche più memoria del computer (RAM) per farlo funzionare e costi maggiori; non sempre il modello più grande è il migliore per il tuo lavoro. E i parametri non sono informazioni salvate in un archivio: non puoi aprire il modello e sfogliarlo come un libro o una pagina web. Sono numeri che, insieme, producono un comportamento.
Come impara, e quando smette di imparare
Un modello impara in due fasi, prima di essere messo al lavoro. Pensa a un nuovo impiegato che, prima di arrivare in ufficio, ha letto una biblioteca infinita. Poi ha seguito un corso su come rispondere ai clienti. Il primo giorno è preparatissimo. Ma della biblioteca non ha portato con sé nemmeno un libro: ha quello che gli è rimasto in testa. E da quel giorno non studia più: legge solo quello che gli metti davanti sul tavolo.
Anche qui è un’analogia, ma rende bene le due fasi. La prima si chiama pre-addestramento: il modello legge una quantità enorme di testo e impara a prevedere il prossimo pezzo di testo. La seconda è una rifinitura, che gli insegna a seguire le istruzioni e a rispondere in modo utile, anche con il giudizio di persone che valutano le risposte. Una tecnica di questo tipo, descritta da OpenAI nel 2022, è stata alla base del primo ChatGPT.
Ne derivano due conseguenze pratiche. Un modello ha una data limite: di ciò che è successo dopo, da solo, non sa nulla. E non impara mentre ci parli: i suoi parametri non cambiano durante la conversazione. Se un servizio sembra aggiornato o sembra ricordarsi di te, è merito di altro, come vedremo fra poco.
Il datacenter: la fabbrica dietro la chat
Un datacenter è un edificio pieno di computer specializzati, in cui i modelli vengono addestrati e che rispondono alle nostre domande. Quando scrivi a ChatGPT, la risposta non viene dal tuo telefono: viene da lì, da macchine collegate alla rete elettrica e raffreddate giorno e notte.
Lì si svolgono due lavori molto diversi. Il primo è l’addestramento, che si fa una sola volta per modello ed è gigantesco. Per dare un’idea dell’ordine di grandezza, nel 2024 Meta ha dichiarato di aver costruito due gruppi da 24.576 processori grafici ciascuno per addestrare Llama 3, il suo modello. Il secondo lavoro si chiama inferenza: è il modello già pronto che risponde alle domande, un po’ alla volta, per milioni di persone.
La differenza è quella che separa costruire una centrale elettrica dall’accendere una luce. Costruire costa moltissimo, una volta. Accendere costa poco, ma tutti i giorni e per tutti.
E l’energia è una questione reale. L’Agenzia internazionale dell’energia stima che nel 2024 i datacenter di tutto il mondo abbiano consumato circa 415 terawattora di elettricità, pari a circa l’1,5% del consumo mondiale, e che entro il 2030 si possa arrivare a circa 945 terawattora, più o meno quanto consuma oggi il Giappone. Non tutto è intelligenza artificiale, ma l’AI è la parte che cresce più in fretta.
ChatGPT è un servizio, non un cervello
ChatGPT è un servizio che utilizza un modello linguistico, ma non è il modello stesso. Arriviamo al punto più utile. Quando apri ChatGPT, stai usando un servizio: un’applicazione di OpenAI, con le sue regole, il suo abbonamento, le sue funzioni. Dentro lavora un modello, o meglio una famiglia di modelli, che OpenAI sceglie, aggiorna e sostituisce nel tempo.
Un’analogia: pensa allo sportello di un ufficio. L’insegna, l’orario, i moduli e l’archivio delle pratiche costituiscono il servizio. L’impiegato dietro lo sportello è il modello. L’ufficio può cambiare impiegato senza cambiare l’insegna.
Con questa distinzione in mente, tre cose che sembrano magie diventano semplici.
- «Cerca su internet.» Il modello da solo non naviga. È il servizio che, quando serve, esegue una ricerca e passa i risultati al modello insieme alla tua domanda.
- «Si ricorda di me.» ChatGPT ha una funzione chiamata Memoria: salva alcune informazioni su di te e, per gli abbonamenti che la prevedono, può tenere conto delle conversazioni passate. Ma è il servizio a conservare questi appunti e a rimetterli sotto gli occhi del modello. Infatti la Memoria si può spegnere dalle impostazioni, e la chat temporanea non la usa.
- «Impara dalle mie conversazioni.» Non in diretta. Però, sugli account personali, l’opzione «Migliora il modello per tutti» è attiva di default: se non la disattivi, le tue conversazioni possono essere utilizzate per addestrare le versioni future. È una scelta effettuata durante i controlli dei dati.
E vale anche il contrario: lo stesso modello può essere impiegato in servizi diversi. Qwen3-8B, per esempio, si può scaricare da Hugging Face, far girare con programmi come Ollama oppure usarlo all’interno di un’applicazione aziendale. Lo vedo tutti i giorni, da quando ho imparato a orchestrare l’AI: in Star2Com lo usiamo all’interno di Work AI, una nostra applicazione, installata sui nostri computer in una versione compressa che occupa 5,2 GB invece di 16. Come si comprime un modello lo vedremo più avanti nella serie.
Che cosa non può fare
Sapere come funziona serve soprattutto a una cosa: capire dove può sbagliare.
Un modello linguistico può sbagliare con sicurezza. Calcola il seguito più probabile, non verifica se è vero: quando non sa, può costruire una risposta convincente e falsa con lo stesso tono di una risposta corretta. Gli informatici la chiamano allucinazione; nella vita di tutti i giorni è un ottimo motivo per verificare nomi, date, numeri e citazioni.
Non sa che cosa sia successo dopo la sua scadenza, a meno che il servizio non faccia una ricerca per lui.
Non è un archivio da consultare: di solito non ti restituisce un documento, te ne scrive uno che gli assomiglia. A volte ripete alla lettera passaggi che ha visto moltissime volte, ma non c’è un libro da sfogliare.
E soprattutto, non sostituisce il giudizio di chi lo usa. È uno strumento potente per scrivere, riassumere, tradurre, ragionare su una bozza. Ma la responsabilità di ciò che esce resta tua. E ricorda che un modello legge tutto come testo, anche le istruzioni nascoste: è il problema dell’agente nel browser che legge anche ciò che non vedi.
In breve
L’intelligenza artificiale è molto più ampia della chat. ChatGPT è un servizio, che usa un modello linguistico, che gira in un datacenter. Il modello prevede il testo un pezzo alla volta, ha imparato fino a una certa data e non cambia mentre ci parli. Tutto ciò che sembra un «ricordo» o un «aggiornamento» è opera del servizio.
Alcuni modelli, però, non richiedono il servizio di un’azienda esterna: si possono scaricare e farli funzionare sul proprio computer. Qwen è uno di questi. Nella prossima puntata me lo porto in casa, e vediamo che cosa cambia, per la privacy e per le prestazioni, quando il datacenter è sulla scrivania.
Domande frequenti
Che cos’è un LLM?
È un modello linguistico di grandi dimensioni: un programma addestrato su moltissimo testo che, data una frase, calcola il pezzo di testo più probabile da aggiungere, un pezzo alla volta. ChatGPT, Claude e Gemini sono servizi che utilizzano modelli di questo tipo.
ChatGPT e GPT sono la stessa cosa?
No. ChatGPT è il servizio, cioè l’applicazione di OpenAI. All’interno lavorano modelli, soprattutto della famiglia GPT, che OpenAI aggiorna e sostituisce nel tempo.
Che cosa sono i token?
Sono i pezzi di testo su cui lavora un modello linguistico: parti di parola, parole brevi, segni di punteggiatura. La lunghezza massima e i prezzi si misurano in token.
Che cosa vuol dire «8 miliardi di parametri»?
Che il modello contiene circa 8 miliardi di parametri interni, fissati durante l’addestramento. Più parametri di solito significano una maggiore capacità, ma anche più memoria del computer (RAM) e costi più elevati. Non sono informazioni archiviate.
ChatGPT impara dalle mie conversazioni?
Non mentre ci parli: il modello non cambia durante la chat. La funzione Memoria del servizio può salvare informazioni su di te e può essere disattivata. Sugli account personali, se non disattivi «Migliora il modello per tutti», le conversazioni possono essere utilizzate per addestrare versioni future.
Fonti
- Regolamento (UE) 2024/1689 sull’intelligenza artificiale, articolo 3, EUR-Lex
- What are tokens and how to count them, OpenAI Help Center
- What is Memory and how do I turn it on or off, OpenAI Help Center
- Data Controls FAQ, OpenAI Help Center
- Qwen3-8B, Hugging Face
- Building Meta’s GenAI Infrastructure, Meta Engineering, 12 marzo 2024
- Training language models to follow instructions with human feedback, Ouyang e altri, 2022
- Energy and AI, Agenzia internazionale dell’energia, 2025